In breve
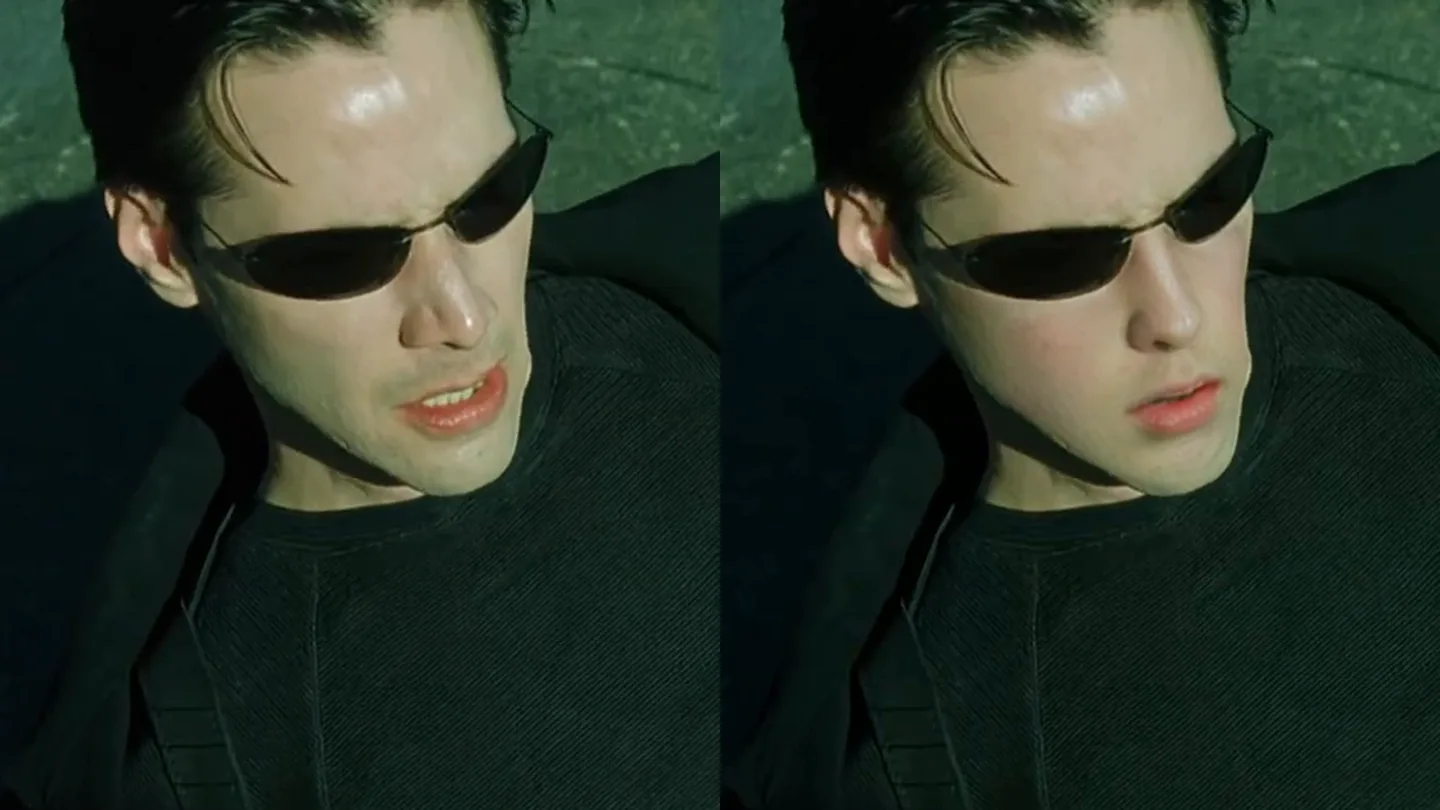
Volevo vedermi in una delle scene più famose del cinema: lo scontro sul tetto di Matrix, quello del “Dodge this”. Il video resta identico, tranne che Neo ha la mia faccia.
L’ho fatto con software gratuito e open source che impara un volto da normali fotografie e lo dipinge su ogni fotogramma in cui compare Neo. Il lavoro pesante è girato per circa nove minuti su una scheda grafica noleggiata in Google Colab, e l’intero esperimento, prove comprese, è costato meno di un’unità di calcolo di Colab.
I primi piani funzionano bene. Le inquadrature più veloci del bullet time mostrano ancora quasi sempre Keanu Reeves, perché lì il suo volto è minuscolo, mosso o capovolto. Le sezioni qui sotto spiegano come è stato fatto e dove non arriva; quelle tecniche sono chiuse.
Il risultato
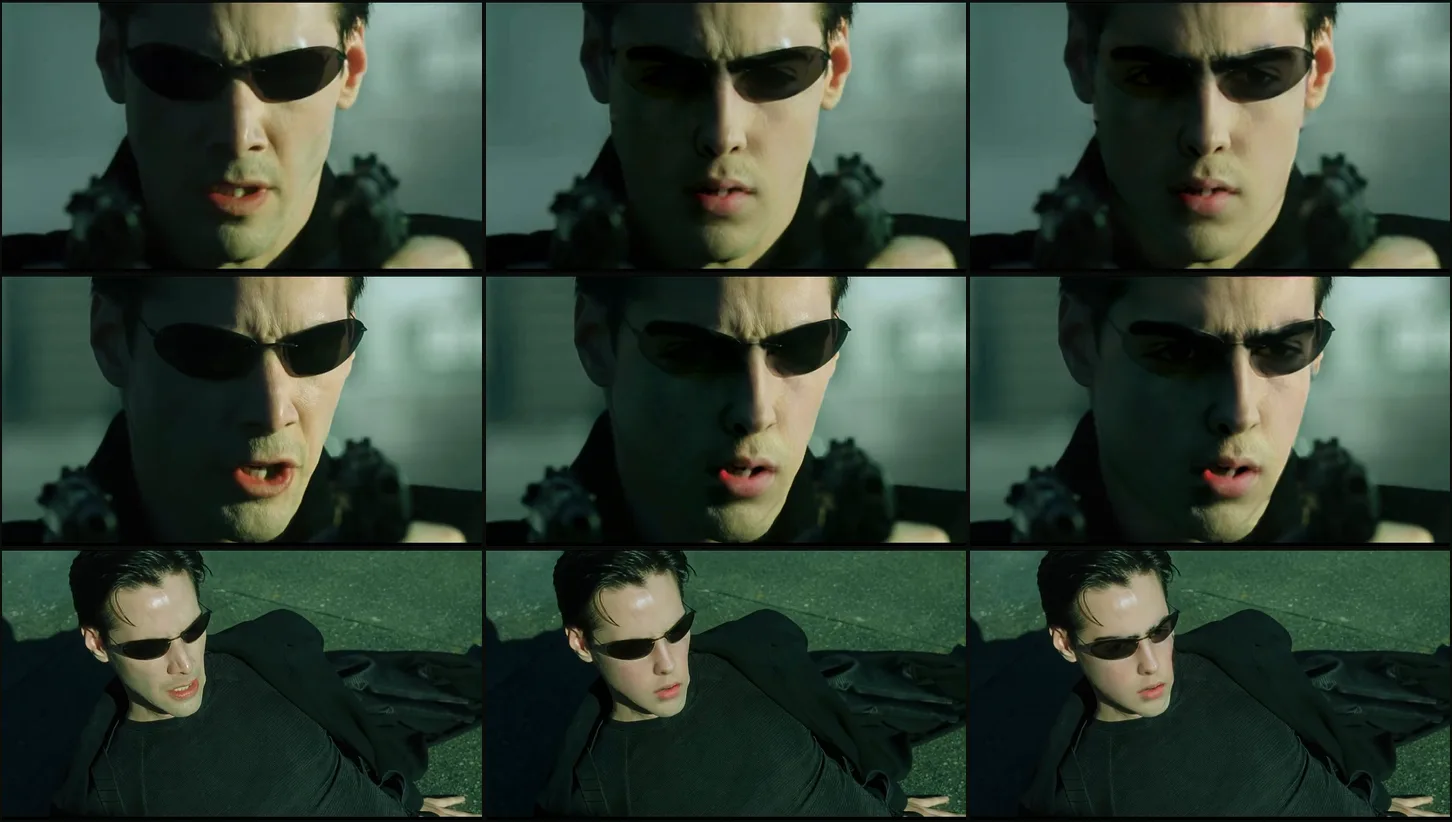
Il mio volto è su Neo in circa 420 dei 1684 fotogrammi della clip, cioè nella maggior parte delle inquadrature in cui il suo viso si vede chiaramente. I momenti migliori sono i primi piani tra 0:28 e 0:34 e Neo a terra tra 0:51 e 0:56. Gli occhiali da sole restano come nel film, con le lenti scure e i riflessi.
Nelle inquadrature di Neo di spalle o di profilo non c’è un volto da cambiare, quindi quei fotogrammi sono gli originali. Ho controllato un fotogramma per ogni secondo della clip in cerca di volti sostituiti per errore e non ne ho trovati. Il vero buco è il bullet time, di cui parlo più sotto.
Cosa ci è entrato
Due ingredienti: la scena e le mie foto. L’unica copia della scena che avevo era quella caricata su YouTube, 1280×720 a 23,976 fotogrammi al secondo, quindi il risultato non può essere più nitido di così.
Per il mio volto ho usato una cartella di 57 foto di un servizio fotografico. Ne ho tenute 21: volto ben visibile, senza occhiali e da angolazioni diverse. Contano più le angolazioni che il numero di foto nella stessa posa, perché la scena mostra Neo dal basso, di lato e sdraiato.
Lo strumento è FaceFusion 3.9.2, una piattaforma open source per la manipolazione dei volti. In ogni fotogramma rileva i volti con un rilevatore basato su YOLO, trova cinque punti di riferimento su ciascuno e allinea il volto a un modello fisso. Il modello di swap prende quel ritaglio allineato e un vettore d’identità e genera la stessa posa, la stessa espressione e la stessa luce con la nuova identità.
Il vettore d’identità viene da ArcFace, un modello di riconoscimento facciale. FaceFusion calcola un vettore per ogni foto di riferimento e ne fa la media, così 21 foto danno un’identità più stabile di una foto sola.
Doveva cambiare solo Neo. Ho indicato a FaceFusion un fotogramma di riferimento, il 672, un primo piano frontale di Neo, e lui confronta ogni volto che rileva con quello. I volti entro una distanza di 0,4 vengono sostituiti, gli Agenti e Trinity restano come sono. Ho attivato anche il rilevamento a 0°, 90° e 270°, perché Neo passa parte della scena di traverso.
Il modello di swap genera 256×256 pixel. Con il pixel boost a 512×512, FaceFusion prende un ritaglio di 512 pixel, lo divide in quattro tasselli da 256, passa ognuno al modello e li ricuce, e nei primi piani il volto risulta più nitido.
python facefusion.py headless-run \
  --source-paths ref/*.jpg \
  --target-path dodge-this.mp4 \
  --face-selector-mode reference --reference-frame-number 672 --reference-face-distance 0.4 \
  --face-detector-angles 0 90 270 \
  --face-mask-types box occlusion region \
  --face-mask-regions skin left-eyebrow right-eyebrow nose mouth upper-lip lower-lip \
  --face-mask-blur 0.4 \
  --processors face_swapper \
  --face-swapper-model hyperswap_1a_256 --face-swapper-pixel-boost 512x512 \
  --execution-providers cuda --output-video-quality 95 \
--output-path dodge-this-luciano.mp4Prima di elaborare la scena intera ho elaborato due volte un breve tratto in primo piano: una con inswapper_128, il modello predefinito da tempo, e una con hyperswap_1a_256. inswapper genera solo 128 pixel, quindi in un primo piano che riempie lo schermo il volto viene morbido. hyperswap conservava più dettaglio della pelle e seguiva meglio le ombre sul viso di Neo, quindi ho usato lui per la versione finale.
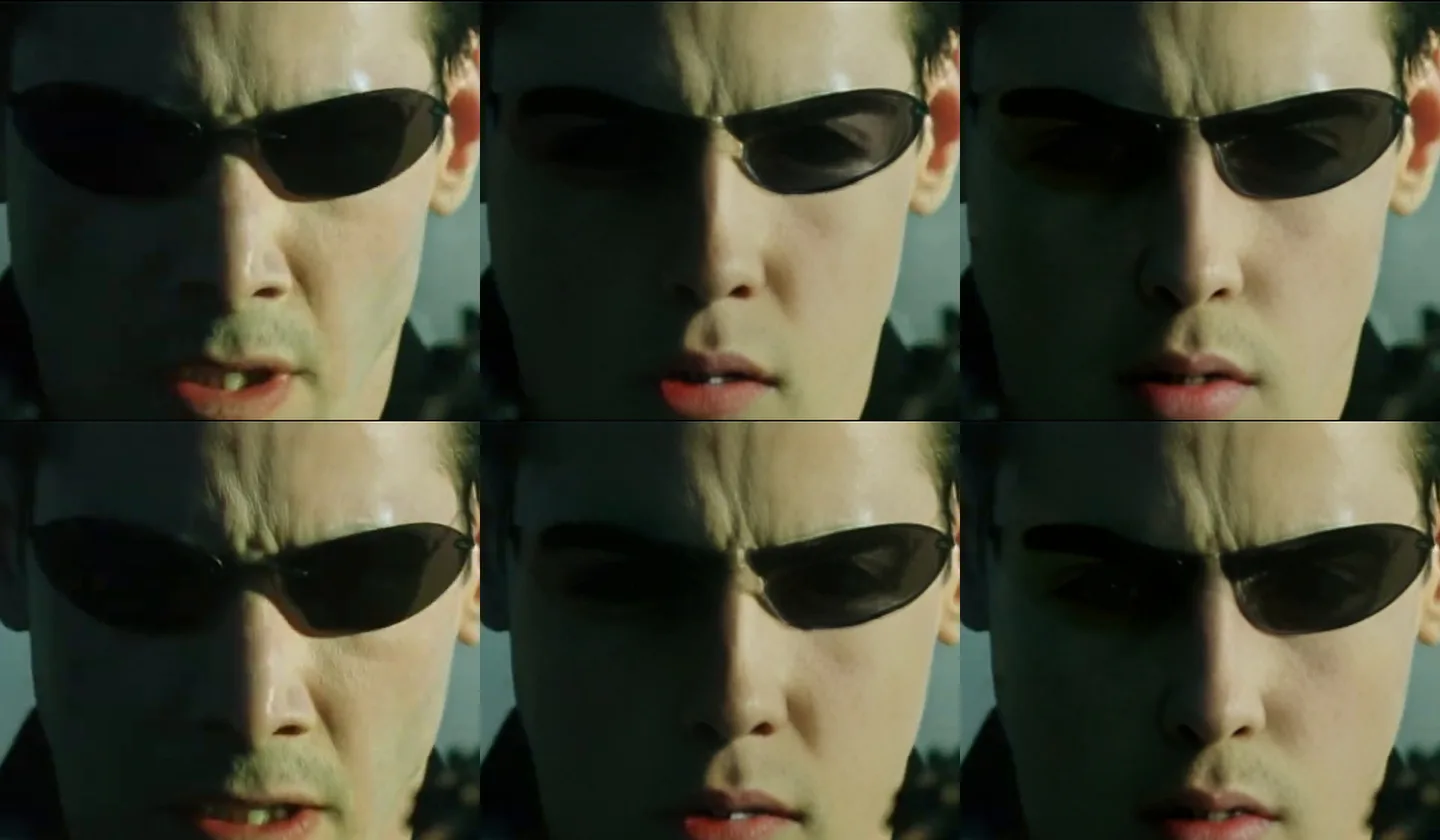
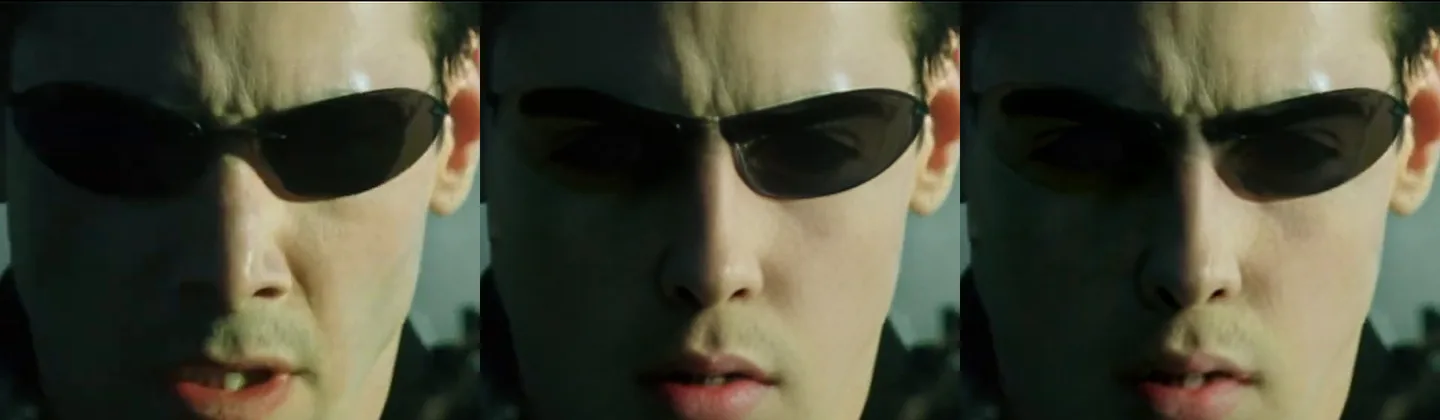
La prima prova cambiava gli occhiali da sole. Il modello di swap ridipinge tutto il ritaglio del volto, quindi i miei occhi e le mie sopracciglia si vedevano attraverso le lenti come se fossero semitrasparenti. La soluzione è stata una maschera per regioni: un modello di segmentazione del volto etichetta ogni pixel come pelle, naso, bocca, occhi, occhiali e così via, e FaceFusion incolla il nuovo volto solo sulle regioni che indico. Lasciando fuori occhi e occhiali, le lenti originali restano sopra.
La maschera a riquadro sfuma il bordo del ritaglio, e la maschera di occlusione evita che mani e oggetti davanti al volto vengano ridipinti.
Ho provato anche GFPGAN, un miglioratore di volti che FaceFusion può applicare dopo lo swap per rendere il risultato più nitido. La pelle migliorava, ma le lenti si schiarivano fino a far vedere gli occhi dietro, quindi la versione finale non usa il miglioratore.
Il mio computer non ha una GPU NVIDIA, e FaceFusion su CPU va bene per un singolo fotogramma ma è lento per una scena intera. Ho usato Google Colab: una NVIDIA T4, che costa 1,15 unità di calcolo all’ora, comandata da uno script invece che da un notebook. Ogni lavoro carica la clip e le foto, installa FaceFusion con onnxruntime-gpu 1.24.4 e le sue librerie CUDA e cuDNN, elabora, scarica il risultato e rilascia la macchina.
L’elaborazione completa dei 1684 fotogrammi ha richiesto 536 secondi, circa 3 fotogrammi al secondo. Tutte le prove e la versione finale insieme hanno consumato 0,68 unità di calcolo.
Una configurazione della GPU non del tutto corretta non sempre ferma un lavoro, quindi ogni lavoro prima sostituisce il volto in un’immagine di prova e controlla che i suoi pixel siano davvero cambiati, e solo dopo passa al video. Tre cose sono comunque andate storte, e ognuna ha cambiato lo script:
- L’output dei programmi avviati dal lavoro non mi arrivava, quindi la prima prova fallita non ha lasciato alcun log. Ora il lavoro cattura da sé l’output di FaceFusion e impacchetta sempre log e risultati, anche quando un passaggio fallisce.
- Il mio primo fotogramma di riferimento, il 575, mostrava la nuca di Neo. FaceFusion non ha trovato nessun volto corrispondente e tre elaborazioni di prova non hanno sostituito nulla. Ora controllo l’immagine del fotogramma di riferimento prima di elaborare.
- Alla fine dell’elaborazione completa, il rilascio della macchina richiedeva un rinnovo dell’accesso a cui lo script non poteva rispondere, e la T4 ha continuato a consumare per qualche minuto finché non l’ho rilasciata a mano. Ora il lavoro verifica dal lato di Colab che nessuna macchina sia ancora assegnata.
Dove non arriva: il bullet time
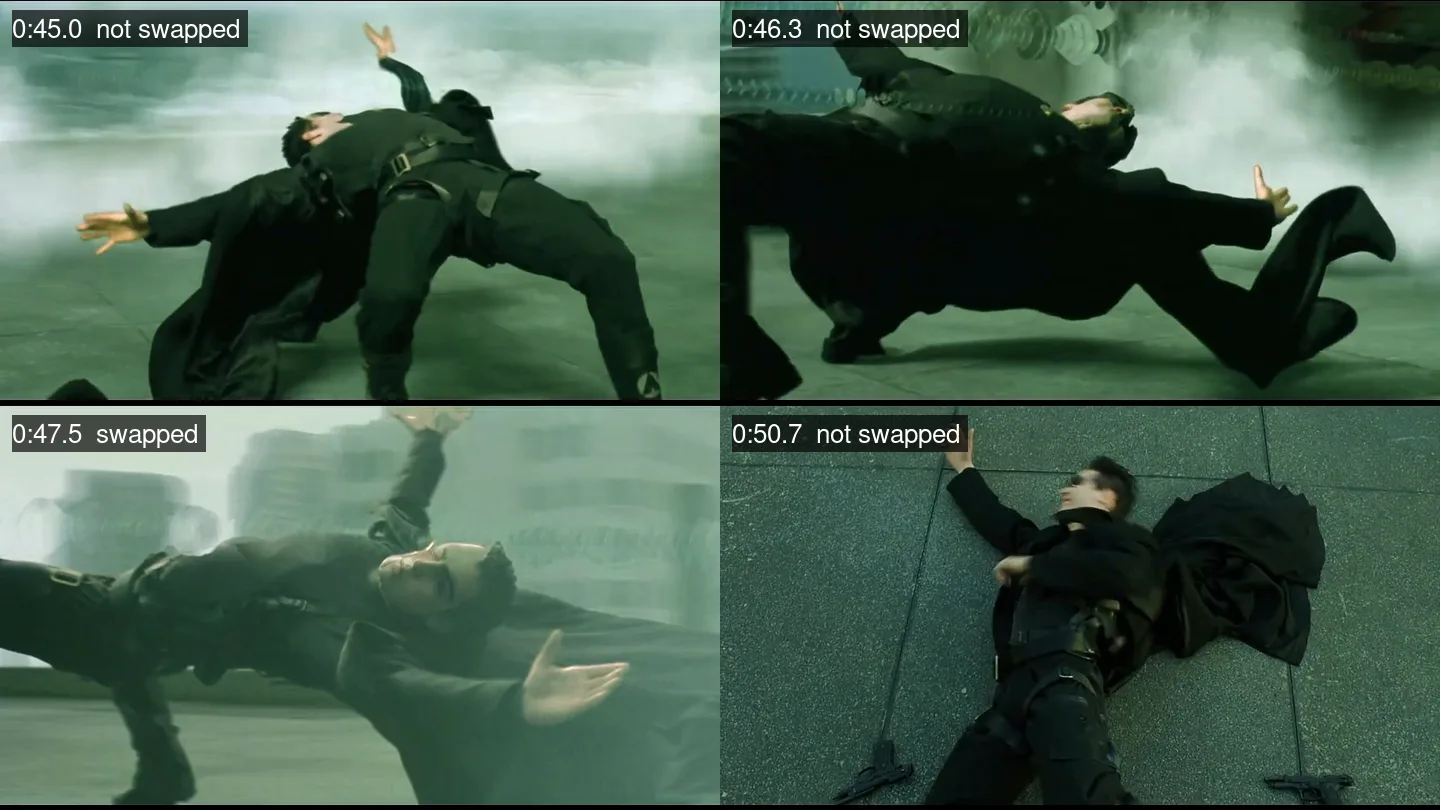
Il bullet time, più o meno da 0:38 a 0:50, è la parte iconica e la più debole del montaggio. Il volto di Neo è piccolo, mosso, di profilo o capovolto, e il rilevatore o non lo trova o lo trova troppo diverso dal riferimento per considerarlo Neo. Solo pochi fotogrammi lì hanno il mio volto, per esempio intorno a 0:44 e 0:47.
Passa in fretta, ma una volta che lo sai si nota. Un secondo passaggio solo su quel tratto dovrebbe recuperarne di più: Neo è il volto più grande sullo schermo in quasi tutti quei fotogrammi, quindi FaceFusion può semplicemente sostituire il volto più grande, con il rilevamento dei volti capovolti e una soglia di rilevamento più bassa. Quel passaggio non l’ho ancora fatto.
E gli occhiali da sole?
Quando ha funzionato, mi sono chiesto come sarebbe stato senza gli occhiali di Neo. La risposta semplice è lasciare che lo swap dipinga anche gli occhi. L’ho provato su tre fotogrammi e gli occhiali non spariscono: il modello di swap copia quello che c’è sul volto originale, quindi i miei occhi finiscono dietro lenti semitrasparenti, con la montatura ancora lì.
Toglierli davvero richiederebbe un altro strumento prima dello swap: un modello di inpainting video come VACE, che ridisegna un’area mascherata coerentemente da un fotogramma all’altro. Lo swap girerebbe poi sul video ripulito, occhi compresi. Serve una GPU più grande, in una scena così scura e veloce il risultato non è garantito, e si perderebbero gli Agenti riflessi nelle lenti, quindi ho tenuto gli occhiali.
Le regole che mi sono dato
L’unico volto che ho aggiunto è il mio, e gli Agenti e Trinity non sono stati toccati. Il montaggio è presentato qui come montaggio, accanto a come è stato fatto, e non lo carico su piattaforme video. Il filmato appartiene a Warner Bros.; questo è un esperimento personale.
FaceFusion è distribuito con licenza OpenRAIL-AS, una licenza per l’IA responsabile che pone limiti al modo in cui può essere usato. Lo stesso strumento che ha messo me in una scena di un film potrebbe mettere qualcuno in un video senza il suo consenso, quindi uso solo volti che ho il diritto di usare.